Un test construit avec le désordre que produit vraiment une paillasse
OpenAI a publié BioBasicsBench, un ensemble de 100 tâches qui demande aux agents d’IA d’interpréter les preuves brutes qu’un scientifique produit en une journée de laboratoire — images de gels, boîtes de gélose, piles de microscopie, écrans d’instruments — et de dire ce que ces preuves étayent, y compris lorsqu’elles n’étayent rien. Au réglage de raisonnement le plus élevé qu’OpenAI publie pour tous les modèles testés, GPT‑6 Astra a obtenu 66,7% des points disponibles, contre 43,8% pour GPT‑5.6 Sol.
Le test a été conçu avec Ligo, une entreprise de biotechnologie travaillant sur la conception d’enzymes, et les scientifiques de Ligo ont rédigé les tâches à partir de leurs propres expériences. OpenAI soutient que les tests existants sont assemblés à partir des graphiques et des images sélectionnés pour la publication dans les articles, ce qui écarte les essais ratés, les images ambiguës et les observations contradictoires qui remplissent un laboratoire en activité.
Ce que contiennent les tâches
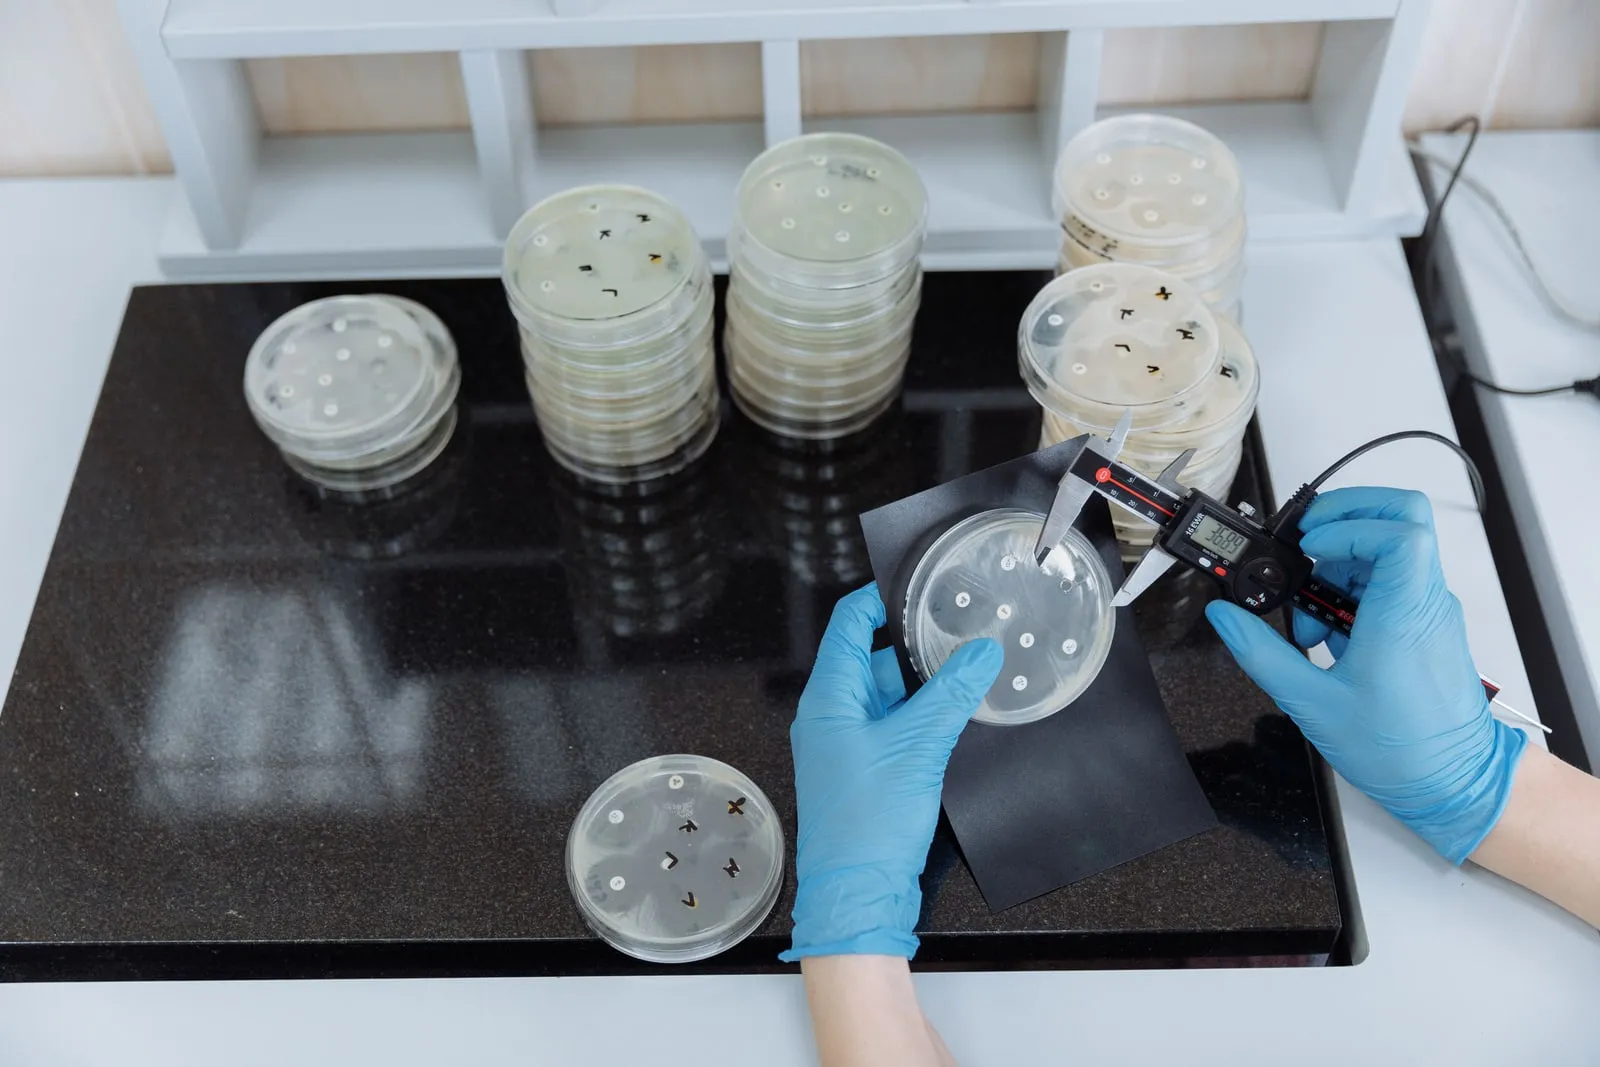
Les tâches couvrent cinq domaines : méthodes protéiques, imagerie et cytométrie, quantification et dosages, méthodes des acides nucléiques et clonage moléculaire. Les gels et les transferts apparaissent dans 31 d’entre elles, les protocoles et les cahiers de laboratoire dans 27, les exports d’instruments et les tableaux dans 20, et les photographies de paillasses, de portoirs et de réactifs dans 18. La microscopie figure dans 14, les fichiers de séquençage dans 12, et sept tâches sont des vidéos de travail de paillasse : étaler une boîte, monter une cuve d’électrophorèse, peser sur une balance.
Chaque tâche est accompagnée d’une grille de notation rédigée par le scientifique qui l’a conçue, de sorte que les points sont attribués critère par critère et non à la seule réponse finale. C’est ce qui permet au test de distinguer une conclusion juste d’une analyse partiellement juste. Chaque tâche a été relue en interne par un scientifique de Ligo qui ne l’avait pas écrite, puis en externe par un scientifique titulaire d’un doctorat travaillant en laboratoire, puis une dernière fois en interne.
Les scores, et qui figure dans le tableau
OpenAI a évalué sept modèles — GPT‑5.2, GPT‑5.4, GPT‑5.5, GPT‑5.6 Sol, GPT‑6.1 Sol, GPT‑6 Luna et GPT‑6 Astra — sur 37 combinaisons de modèle et d’effort de raisonnement, avec cinq tentatives sur chacune des 100 tâches, soit 18 500 résultats au total. Au réglage xhigh, l’ordre est Astra à 66,7%, GPT‑6.1 Sol à 62,0%, GPT‑5.6 Sol à 43,8%, GPT‑6 Luna à 38,3%, GPT‑5.5 à 35,4%, GPT‑5.4 à 33,2% et GPT‑5.2 à 31,2%. Les intervalles de confiance sont larges : celui d’Astra à 95% va de 60,3% à 73,1% et chevauche celui de GPT‑6.1 Sol.
Tous les modèles de ce tableau sont ceux d’OpenAI. Le test est celui d’OpenAI, les tâches ont été commandées par OpenAI et aucun système concurrent n’y a été soumis. Les chiffres décrivent des mouvements au sein de la gamme d’un seul fournisseur, non un classement entre laboratoires.
Le nombre de jetons va dans le sens inverse des scores. Astra a atteint 66,7% avec en moyenne 4 704 jetons de sortie par tâche, tandis que GPT‑5.2 en a dépensé 27 620 pour atteindre 31,2%.
Là où le meilleur modèle échoue encore
Le texte d’OpenAI est inhabituellement direct sur les erreurs d’Astra. Sur une tâche de PCR sur colonies, le modèle a correctement regroupé les bandes mais a attribué à chaque groupe la mauvaise identité expérimentale, en supposant que le produit le plus grand désignait le clone réussi : il a proposé les colonies 4, 6, 7 et 8 là où la référence retient 5, 9 et 10 — une erreur qui enverrait le mauvais plasmide à la purification. Chargé de compter des colonies sur une boîte, il n’a pas séparé les voisines proches, a manqué des colonies visibles, a marqué de la gélose vide et a surcompté d’environ 12%. Sur une tâche de microscopie, il a observé que le contraste varie avec la profondeur de mise au point puis a abandonné l’observation, concluant que les vacuoles sont généralement plus sombres que la cellule qui les entoure alors que des vacuoles plus claires figuraient dans le même champ.
Les réussites sont de la même nature que les échecs. Astra a rejeté une boîte de contrôle négatif après avoir lu « LB Kan50 » sur le bord — de la kanamycine, et non l’ampicilline utilisée dans l’expérience — et a reconnu une série d’images de microscope comme un balayage en profondeur là où GPT‑5.6 Sol cherchait une raison biologique à la disparition des cellules.
Ce qu’il faut surveiller
OpenAI affirme que les gains tiennent à une capacité multimodale native plus forte plutôt qu’à davantage de raisonnement. L’épreuve de cette lecture sera de voir si quelqu’un hors d’OpenAI exécute le test. Tant qu’un modèle concurrent ne figure pas dans le tableau, 66,7% est un chiffre sur Astra, pas sur l’état de l’art.