Ett test byggt av röran som en laboratoriebänk faktiskt ger
OpenAI har publicerat BioBasicsBench, 100 uppgifter som ber AI-agenter tolka de rå bevis en laboratorieforskare skapar under en arbetsdag — gelbilder, agarplattor, mikroskopibildstaplar, instrumentskärmar — och säga vad bevisen stöder, också när de inte stöder något. Vid den högsta resonemangsnivå OpenAI redovisar för samtliga testade modeller tog GPT‑6 Astra 66,7 procent av den tillgängliga poängen, mot 43,8 procent för GPT‑5.6 Sol.
Testet byggdes med Ligo, ett bioteknikbolag som arbetar med enzymdesign, och Ligos forskare skrev uppgifterna utifrån sina egna experiment. OpenAI menar att befintliga tester sätts samman av de diagram och bilder som valts ut för publicering i artiklar, vilket utelämnar de misslyckade körningarna, de tvetydiga bilderna och de motstridiga observationer som fyller ett laboratorium i drift.
Vad uppgifterna innehåller
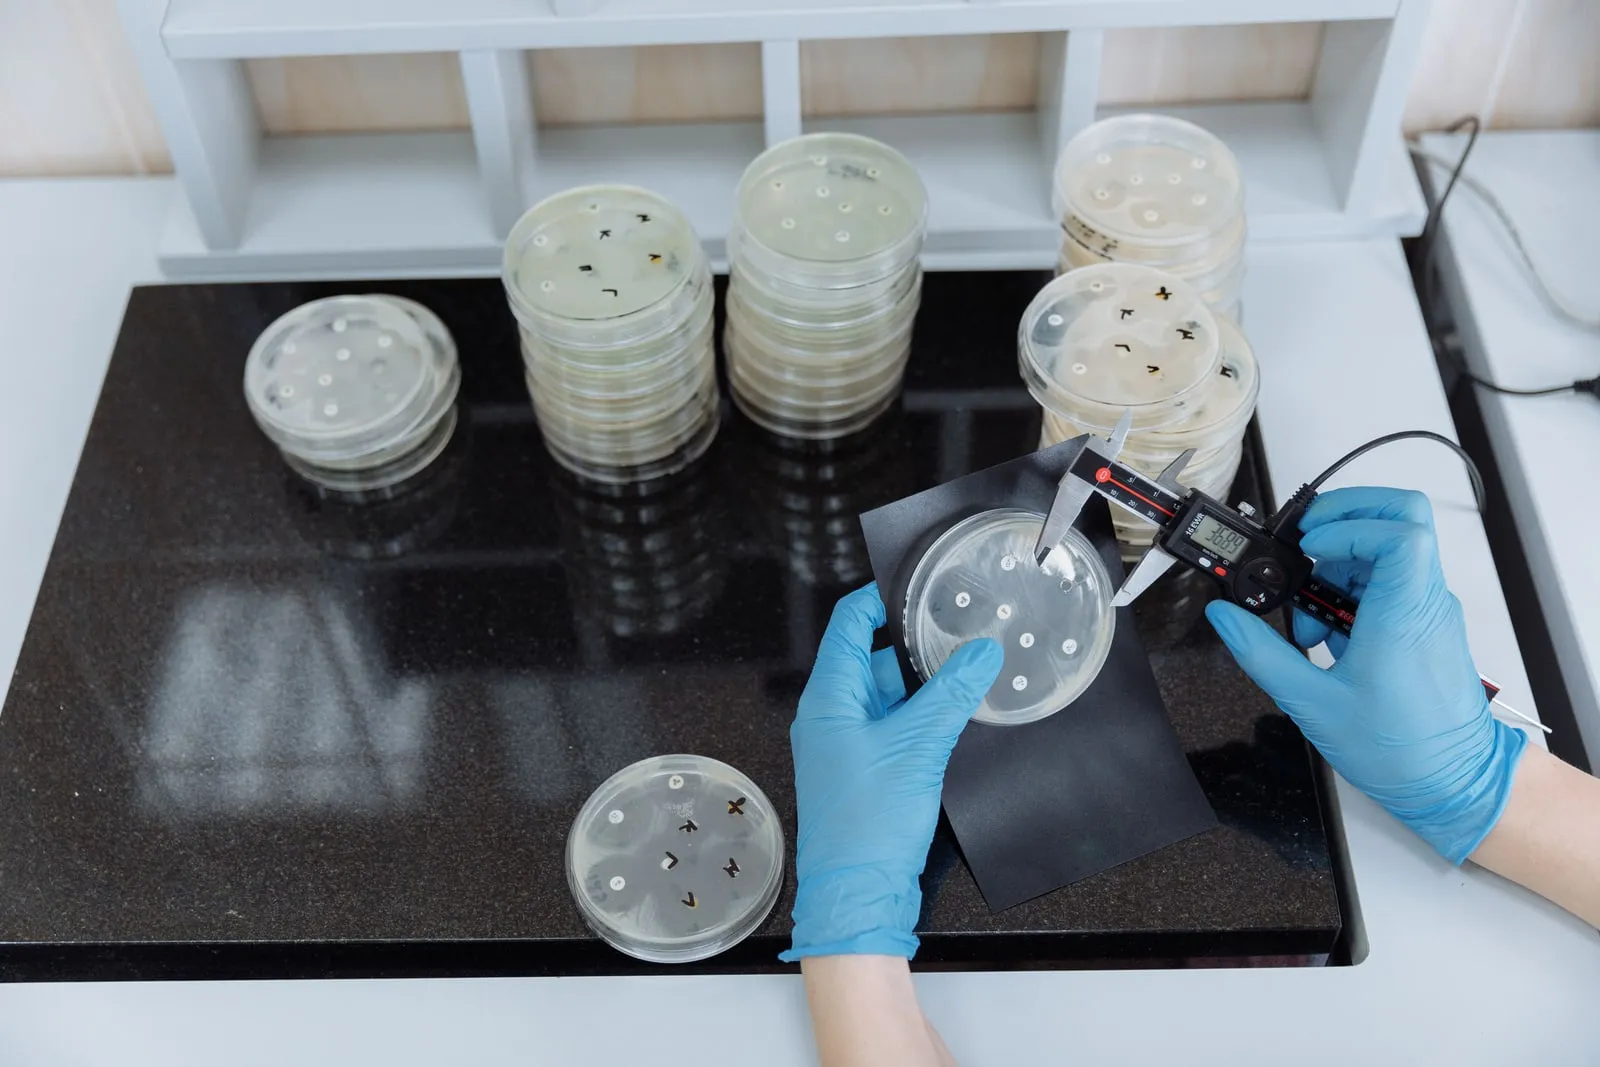
Uppgifterna täcker fem områden: proteinmetoder, bild och cytometri, kvantifiering och analyser, nukleinsyrametoder samt molekylär kloning. Geler och blottar förekommer i 31 av dem, protokoll och laboratorieanteckningar i 27, instrumentexporter och tabeller i 20 och fotografier av bänkar, stativ och reagens i 18. Mikroskopi finns i 14, sekvenseringsfiler i 12, och sju uppgifter är videor av bänkarbete: att stryka ut en platta, rigga en elektroforeskyvett, väga på en våg.
Varje uppgift har en bedömningsmall skriven av den forskare som utformade den, så poäng ges kriterium för kriterium och inte bara för slutsvaret. Det är vad som låter testet skilja en riktig slutsats från en delvis riktig analys. Varje uppgift granskades internt av en Ligo-forskare som inte skrivit den, sedan externt av en disputerad forskare som arbetar i laboratorium, och därefter internt en gång till.
Poängen, och vilka som står i tabellen
OpenAI utvärderade sju modeller — GPT‑5.2, GPT‑5.4, GPT‑5.5, GPT‑5.6 Sol, GPT‑6.1 Sol, GPT‑6 Luna och GPT‑6 Astra — i 37 kombinationer av modell och resonemangsnivå, med fem försök på var och en av de 100 uppgifterna, alltså 18 500 resultat. På nivån xhigh är ordningen Astra på 66,7 procent, GPT‑6.1 Sol på 62,0, GPT‑5.6 Sol på 43,8, GPT‑6 Luna på 38,3, GPT‑5.5 på 35,4, GPT‑5.4 på 33,2 och GPT‑5.2 på 31,2. Konfidensintervallen är vida: Astras 95-procentsintervall går från 60,3 till 73,1 procent och överlappar GPT‑6.1 Sols.
Varje modell i tabellen är OpenAI:s egen. Testet är OpenAI:s, uppgifterna beställdes av OpenAI och inget konkurrerande system har körts på det. Siffrorna beskriver rörelser inom en enda leverantörs sortiment, inte en rangordning mellan laboratorier.
Tokenräkningen går åt motsatt håll mot poängen. Astra nådde 66,7 procent på i genomsnitt 4 704 utdatatokens per uppgift, medan GPT‑5.2 gjorde av med 27 620 tokens för att nå 31,2 procent.
Där den bästa modellen fortfarande fallerar
OpenAI:s text är ovanligt rak om vad Astra gjorde fel. I en uppgift om koloni-PCR grupperade modellen banden riktigt men gav varje grupp fel experimentell identitet, eftersom den antog att den större produkten markerade den lyckade klonen: den föreslog kolonierna 4, 6, 7 och 8 där referensen väljer 5, 9 och 10 — ett fel som skulle skicka fel plasmid vidare till rening. När den ombads räkna kolonier på en platta kunde den inte särskilja närliggande kolonier, missade synliga kolonier, markerade tom agar och räknade för högt med omkring 12 procent. I en mikroskopiuppgift noterade den att kontrasten varierar med fokusdjupet och släppte sedan iakttagelsen, med slutsatsen att vakuoler generellt är mörkare än den omgivande cellen trots att ljusare låg i samma bildfält.
Träffarna är av samma slag som missarna. Astra förkastade en negativ kontrollplatta efter att ha läst “LB Kan50” på kanten — kanamycin, inte ampicillinet som experimentet använde — och kände igen en serie mikroskopbilder som en djupskanning där GPT‑5.6 Sol letade efter ett biologiskt skäl till att cellerna försvunnit.
Vad man ska bevaka
OpenAI säger att förbättringarna pekar på starkare inbyggd multimodal förmåga snarare än på mer resonemang. Provet på den tolkningen är om någon utanför OpenAI kör testet. Till dess att en konkurrerande modell står i tabellen är 66,7 procent en siffra om Astra, inte om teknikens frontlinje.