Un banco de pruebas hecho con el desorden que produce un laboratorio
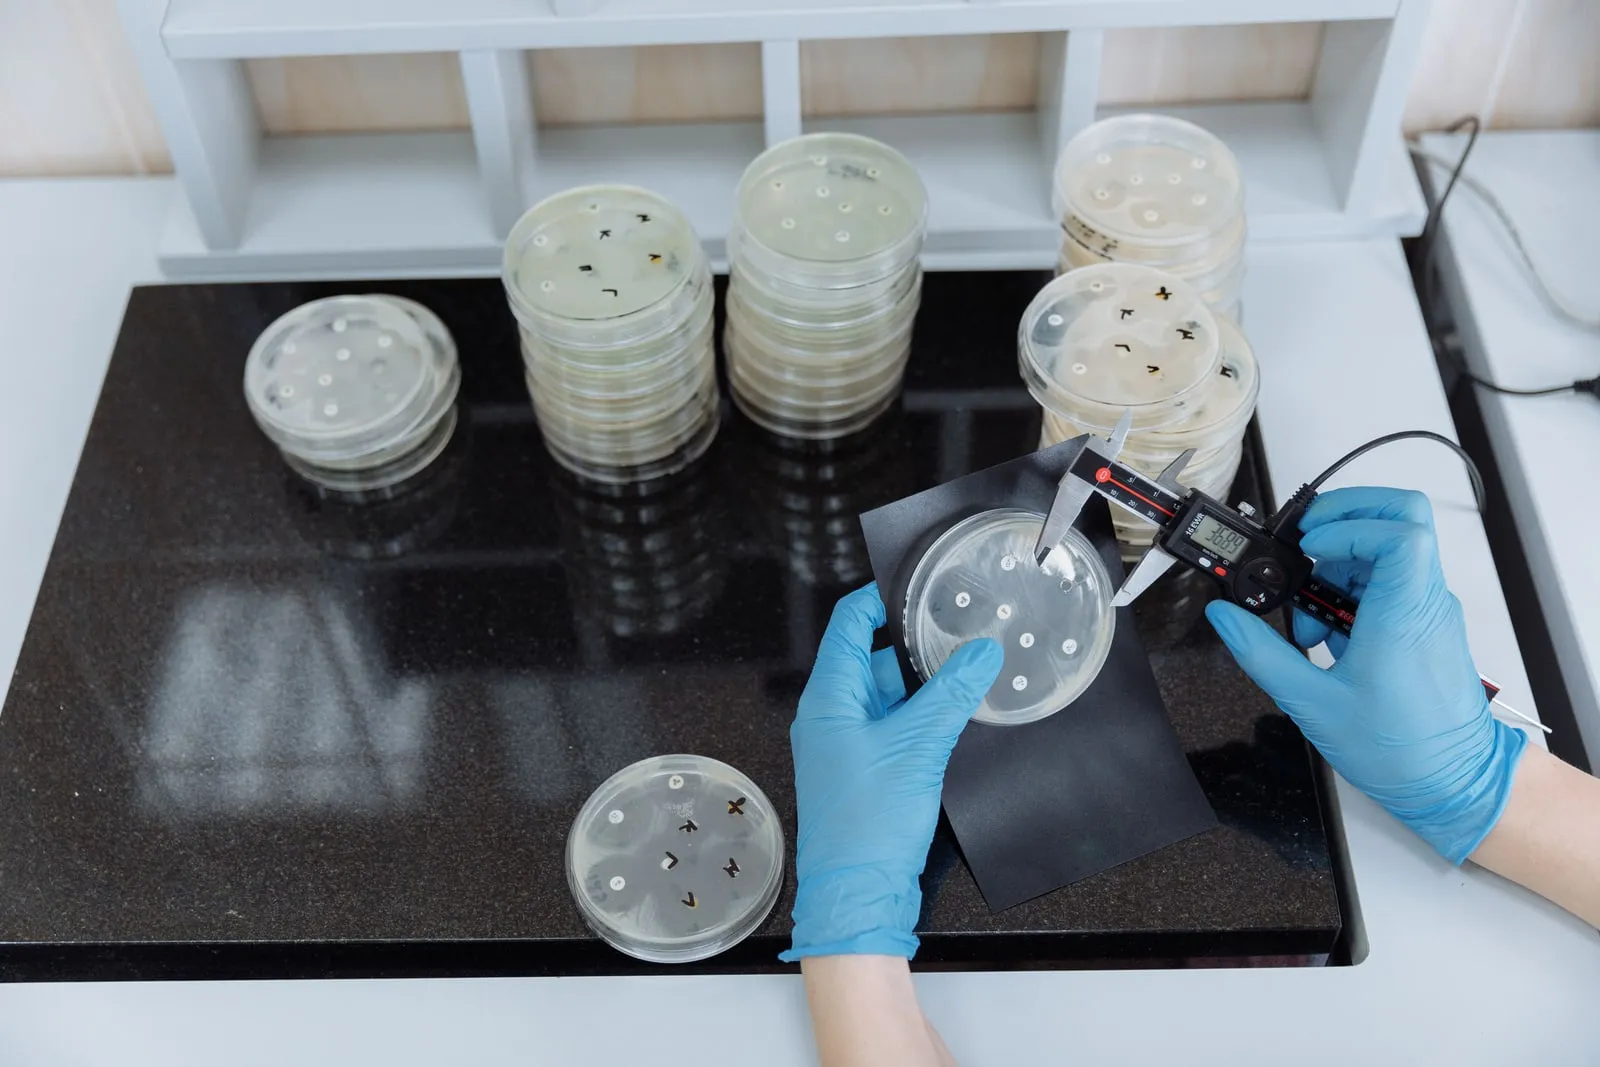
OpenAI ha publicado BioBasicsBench, un conjunto de 100 tareas que pide a los agentes de IA interpretar las pruebas en bruto que un científico genera en una jornada de laboratorio — imágenes de geles, placas de agar, pilas de microscopía, pantallas de instrumentos — y decir qué respaldan esas pruebas, incluido cuándo no respaldan nada. En el ajuste de razonamiento más alto que OpenAI publica para todos los modelos evaluados, GPT‑6 Astra obtuvo el 66,7% del crédito disponible, frente al 43,8% de GPT‑5.6 Sol.
El banco de pruebas se construyó con Ligo, una empresa de biotecnología centrada en el diseño de enzimas, y sus científicos redactaron las tareas a partir de sus propios experimentos. OpenAI sostiene que los bancos de pruebas existentes se montan con los gráficos e imágenes seleccionados para publicar en artículos, lo que deja fuera los ensayos fallidos, las imágenes ambiguas y las observaciones contradictorias que llenan un laboratorio en funcionamiento.
Qué contienen las tareas
Las tareas abarcan cinco áreas: métodos de proteínas, imagen y citometría, cuantificación y ensayos, métodos de ácidos nucleicos y clonación molecular. Los geles y las transferencias aparecen en 31 de ellas, los protocolos y cuadernos de laboratorio en 27, las exportaciones de instrumentos y las tablas en 20, y las fotografías de mesas, gradillas y reactivos en 18. La microscopía figura en 14, los archivos de secuenciación en 12, y siete tareas son vídeos de trabajo de mesa: sembrar una placa, montar una cubeta de electroforesis, pesar en una balanza.
Cada tarea lleva una rúbrica de corrección escrita por el científico que la planteó, así que el crédito se asigna criterio por criterio y no sólo a la respuesta final. Eso permite al banco de pruebas distinguir una conclusión correcta de un análisis parcialmente correcto. Cada tarea pasó una revisión interna de un científico de Ligo que no la había escrito, otra externa de un científico doctorado que trabaja en laboratorio y una última revisión interna.
Las puntuaciones y quién aparece en la tabla
OpenAI evaluó siete modelos — GPT‑5.2, GPT‑5.4, GPT‑5.5, GPT‑5.6 Sol, GPT‑6.1 Sol, GPT‑6 Luna y GPT‑6 Astra — en 37 combinaciones de modelo y esfuerzo de razonamiento, con cinco intentos en cada una de las 100 tareas, para 18.500 resultados en total. En el ajuste xhigh el orden es Astra con el 66,7%, GPT‑6.1 Sol con el 62,0%, GPT‑5.6 Sol con el 43,8%, GPT‑6 Luna con el 38,3%, GPT‑5.5 con el 35,4%, GPT‑5.4 con el 33,2% y GPT‑5.2 con el 31,2%. Los intervalos de confianza son amplios: el del 95% de Astra va del 60,3% al 73,1% y se solapa con el de GPT‑6.1 Sol.
Todos los modelos de esa tabla son de OpenAI. El banco de pruebas es de OpenAI, las tareas las encargó OpenAI y ningún sistema de la competencia se ha ejecutado en él. Las cifras describen el movimiento dentro del catálogo de un solo proveedor, no una clasificación entre laboratorios.
Los recuentos de tokens van en dirección contraria a las puntuaciones. Astra alcanzó el 66,7% con una media de 4.704 tokens de salida por tarea, mientras que GPT‑5.2 gastó 27.620 tokens para llegar al 31,2%.
Dónde sigue fallando el mejor modelo
El texto de OpenAI es inusualmente directo sobre los errores de Astra. En una tarea de PCR de colonias agrupó bien las bandas, pero asignó a cada grupo la identidad experimental equivocada al suponer que el producto más grande marcaba el clon logrado: propuso las colonias 4, 6, 7 y 8 donde la referencia selecciona 5, 9 y 10, un error que enviaría el plásmido equivocado a purificación. Al contar colonias en una placa, no separó las vecinas próximas, se dejó colonias visibles, marcó agar vacío y sobrecontó en torno al 12%. En una tarea de microscopía observó que el contraste varía con la profundidad de enfoque y luego descartó la observación, concluyendo que las vacuolas son en general más oscuras que la célula que las rodea mientras otras más claras estaban en el mismo campo.
Los aciertos son del mismo tipo que los fallos. Astra rechazó una placa de control negativo tras leer “LB Kan50” en el borde — kanamicina, no la ampicilina usada en el experimento — y reconoció una serie de imágenes de microscopio como un barrido en profundidad donde GPT‑5.6 Sol buscaba una razón biológica para la desaparición de las células.
Qué vigilar
OpenAI dice que las mejoras apuntan a una capacidad multimodal nativa más fuerte y no a más razonamiento. La prueba de esa lectura es si alguien ajeno a OpenAI ejecuta el banco de pruebas. Hasta que un modelo rival aparezca en la tabla, el 66,7% es una cifra sobre Astra, no sobre el estado del arte.