Um teste feito com a desordem que uma bancada realmente produz
A OpenAI publicou o BioBasicsBench, um conjunto de 100 tarefas que pede a agentes de IA para interpretar as provas brutas que um cientista gera num dia de laboratório — imagens de géis, placas de agar, pilhas de microscopia, ecrãs de instrumentos — e dizer o que essas provas sustentam, incluindo quando não sustentam nada. Na configuração de raciocínio mais alta que a OpenAI divulga para todos os modelos testados, o GPT‑6 Astra obteve 66,7% da pontuação disponível, contra 43,8% do GPT‑5.6 Sol.
O teste foi construído com a Ligo, uma empresa de biotecnologia dedicada ao desenho de enzimas, e os cientistas da Ligo escreveram as tarefas a partir das suas próprias experiências. A OpenAI argumenta que os testes existentes são montados com os gráficos e as imagens selecionados para publicação em artigos, o que deixa de fora os ensaios falhados, as imagens ambíguas e as observações contraditórias que enchem um laboratório em funcionamento.
O que contêm as tarefas
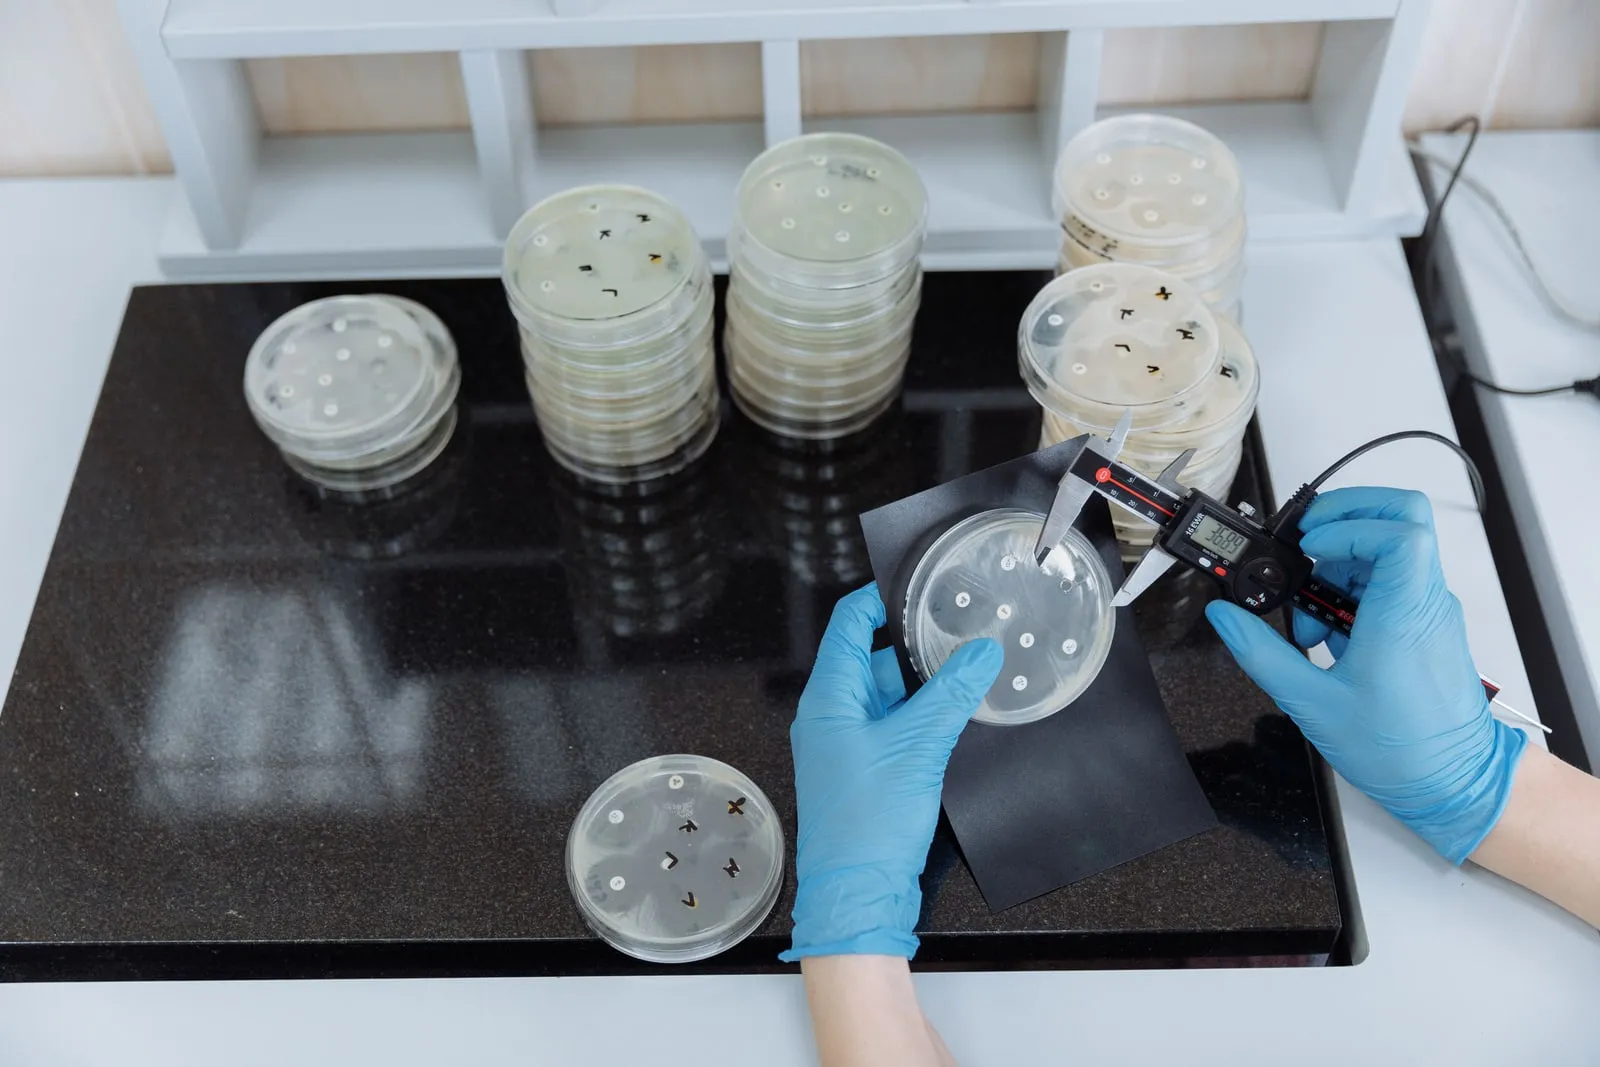
As tarefas abrangem cinco áreas: métodos de proteínas, imagem e citometria, quantificação e ensaios, métodos de ácidos nucleicos e clonagem molecular. Géis e transferências aparecem em 31 delas, protocolos e cadernos de laboratório em 27, exportações de instrumentos e tabelas em 20, e fotografias de bancadas, suportes e reagentes em 18. A microscopia figura em 14, os ficheiros de sequenciação em 12, e sete tarefas são vídeos de trabalho de bancada: semear uma placa, montar uma cuba de eletroforese, pesar numa balança.
Cada tarefa inclui uma grelha de avaliação escrita pelo cientista que a concebeu, pelo que a pontuação é atribuída critério a critério e não apenas à resposta final. É isso que permite ao teste distinguir uma conclusão correta de uma análise parcialmente correta. Cada tarefa passou por revisão interna de um cientista da Ligo que não a tinha escrito, depois por revisão externa de um cientista doutorado a trabalhar em laboratório, e por uma última revisão interna.
As pontuações e quem está na tabela
A OpenAI avaliou sete modelos — GPT‑5.2, GPT‑5.4, GPT‑5.5, GPT‑5.6 Sol, GPT‑6.1 Sol, GPT‑6 Luna e GPT‑6 Astra — em 37 combinações de modelo e esforço de raciocínio, com cinco tentativas em cada uma das 100 tarefas, num total de 18 500 resultados. Na configuração xhigh a ordem é Astra com 66,7%, GPT‑6.1 Sol com 62,0%, GPT‑5.6 Sol com 43,8%, GPT‑6 Luna com 38,3%, GPT‑5.5 com 35,4%, GPT‑5.4 com 33,2% e GPT‑5.2 com 31,2%. Os intervalos de confiança são amplos: o de 95% do Astra vai de 60,3% a 73,1% e sobrepõe-se ao do GPT‑6.1 Sol.
Todos os modelos dessa tabela são da OpenAI. O teste é da OpenAI, as tarefas foram encomendadas pela OpenAI e nenhum sistema concorrente foi executado nele. Os números descrevem o movimento dentro da gama de um único fornecedor, não uma classificação entre laboratórios.
A contagem de tokens segue a direção oposta à das pontuações. O Astra chegou aos 66,7% com uma média de 4 704 tokens de saída por tarefa, enquanto o GPT‑5.2 gastou 27 620 tokens para chegar a 31,2%.
Onde o melhor modelo ainda falha
O texto da OpenAI é invulgarmente direto sobre os erros do Astra. Numa tarefa de PCR de colónias agrupou bem as bandas, mas atribuiu a cada grupo a identidade experimental errada, ao supor que o produto maior assinalava o clone bem-sucedido: propôs as colónias 4, 6, 7 e 8 onde a referência seleciona 5, 9 e 10 — um erro que enviaria o plásmido errado para purificação. Ao contar colónias numa placa, não separou as vizinhas próximas, deixou passar colónias visíveis, marcou agar vazio e contou cerca de 12% a mais. Numa tarefa de microscopia observou que o contraste varia com a profundidade de foco e depois abandonou a observação, concluindo que os vacúolos são em geral mais escuros do que a célula circundante quando outros mais claros estavam no mesmo campo.
Os acertos são do mesmo género que as falhas. O Astra rejeitou uma placa de controlo negativo depois de ler «LB Kan50» na borda — canamicina, e não a ampicilina usada na experiência — e reconheceu uma série de imagens de microscópio como uma varredura em profundidade onde o GPT‑5.6 Sol procurava uma razão biológica para as células terem desaparecido.
O que vigiar
A OpenAI diz que os ganhos apontam para uma capacidade multimodal nativa mais forte e não para mais raciocínio. A prova dessa leitura é se alguém fora da OpenAI executar o teste. Enquanto um modelo rival não aparecer na tabela, 66,7% é um número sobre o Astra, não sobre o estado da arte.