اختبار مبني على الفوضى التي ينتجها المختبر فعلًا
نشرت OpenAI معيار بايوبيسيكس بنش، وهو مجموعة من 100 مهمة تطلب من وكلاء الذكاء الاصطناعي تفسير الأدلة الخام التي يولّدها عالم المختبر في يوم عمل واحد — صور الهلام، وأطباق الآغار، وأكوام صور المجهر، وشاشات الأجهزة — وأن يقولوا ما تسنده هذه الأدلة، بما في ذلك متى لا تسند شيئًا. وعند أعلى مستوى استدلال تنشره OpenAI لكل النماذج التي اختبرتها، حصل GPT‑6 أسترا على 66.7% من النقاط المتاحة، مقابل 43.8% لـ GPT‑5.6 سول.
بُني الاختبار مع ليغو، وهي شركة تقنية حيوية تعمل على تصميم الإنزيمات، وكتب علماء ليغو المهام انطلاقًا من تجاربهم الخاصة. وتقول OpenAI إن المعايير القائمة تُجمع من الرسوم والصور المنتقاة للنشر في الأوراق البحثية، وهو ما يستبعد التجارب الفاشلة والصور الملتبسة والملاحظات المتناقضة التي يمتلئ بها مختبر عامل.
ما تحتويه المهام
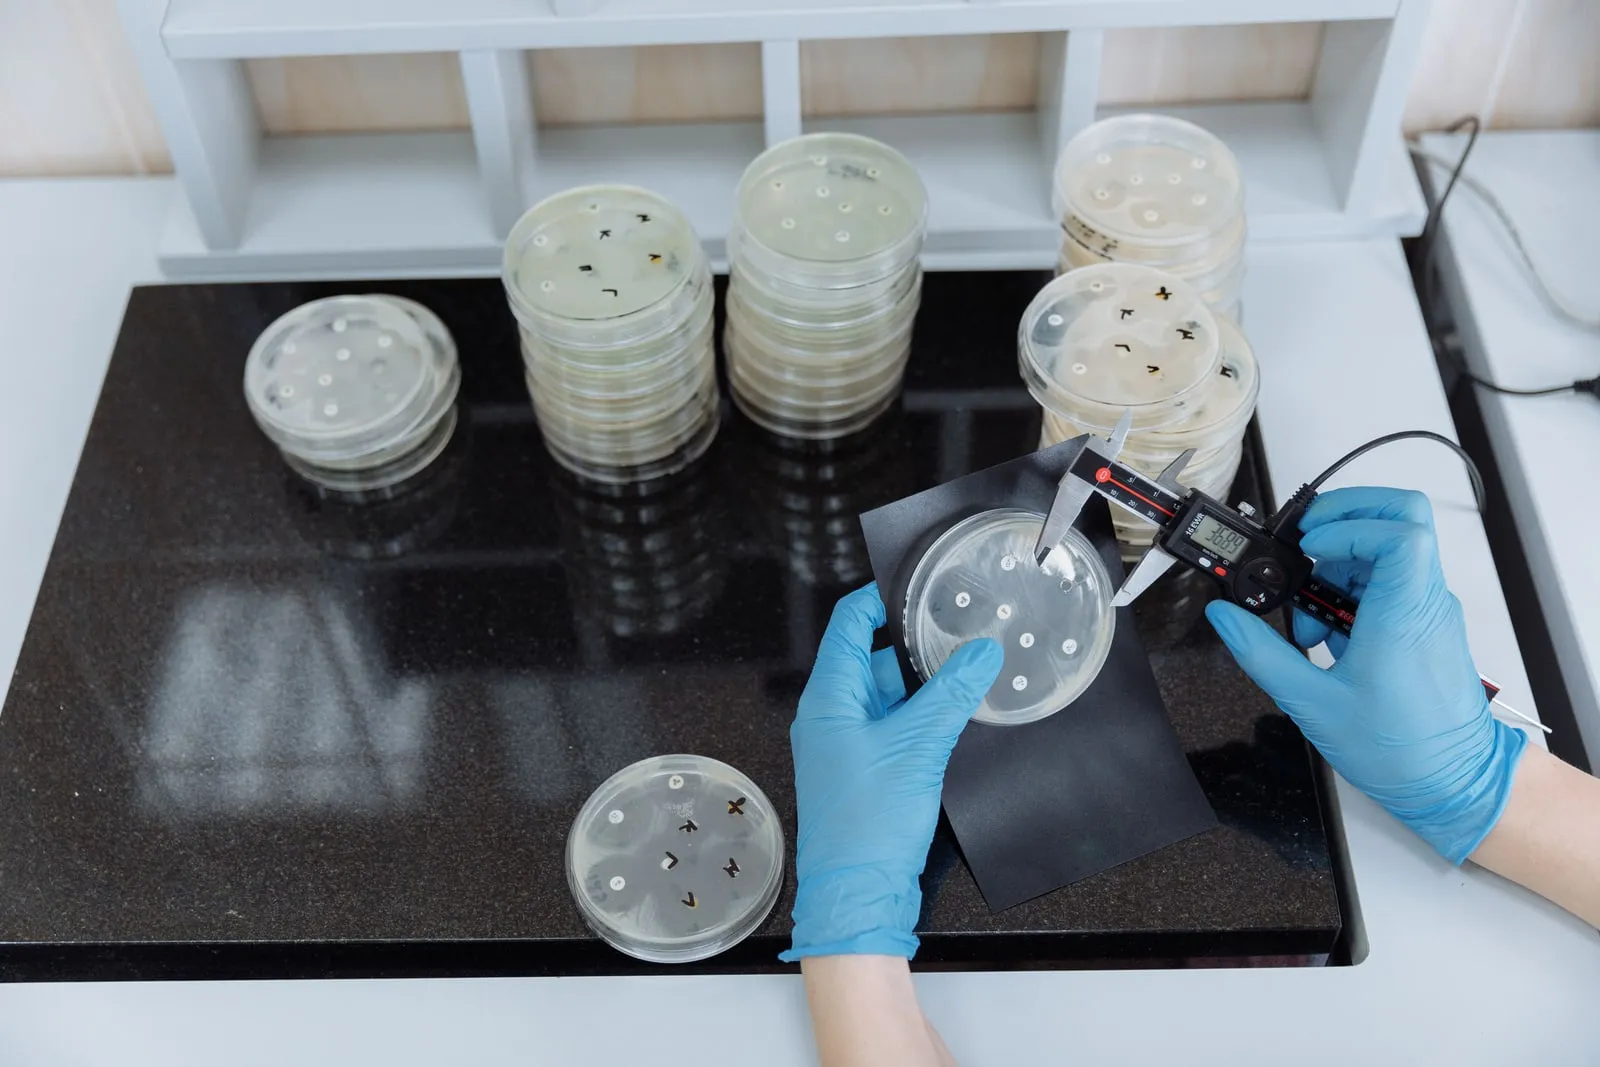
تغطي المهام خمسة مجالات: طرائق البروتين، والتصوير وقياس الخلايا، والقياس الكمي والمقايسات، وطرائق الأحماض النووية، والاستنساخ الجزيئي. ويظهر الهلام واللطخات في 31 منها، والبروتوكولات ودفاتر المختبر في 27، ومخرجات الأجهزة والجداول في 20، وصور المناضد والحمالات والكواشف في 18. ويحضر المجهر في 14، وملفات التسلسل في 12، وسبع مهام هي مقاطع فيديو لعمل المنضدة: تخطيط طبق، وتجهيز حوض الفصل الكهربائي، والوزن على ميزان.
تحمل كل مهمة شبكة تصحيح كتبها العالم الذي صاغها، فتُمنح النقاط معيارًا بمعيار لا للجواب النهائي وحده. وهذا ما يتيح للاختبار أن يفرّق بين استنتاج صحيح وتحليل صحيح جزئيًا. وقد راجع كل مهمة داخليًا عالم من ليغو لم يكتبها، ثم راجعها خارجيًا عالم حامل للدكتوراه يعمل في مختبر، ثم راجعت داخليًا مرة أخرى.
النتائج، ومن في الجدول
قيّمت OpenAI سبعة نماذج — GPT‑5.2 وGPT‑5.4 وGPT‑5.5 وGPT‑5.6 سول وGPT‑6.1 سول وGPT‑6 لونا وGPT‑6 أسترا — عبر 37 تهيئة للنموذج ومستوى الاستدلال، بخمس محاولات على كل من المهام المئة، أي 18,500 نتيجة في المجموع. وعند مستوى xhigh يأتي الترتيب: أسترا 66.7%، وGPT‑6.1 سول 62.0%، وGPT‑5.6 سول 43.8%، وGPT‑6 لونا 38.3%، وGPT‑5.5 35.4%، وGPT‑5.4 33.2%، وGPT‑5.2 31.2%. ومجالات الثقة واسعة: مجال أسترا عند 95% يمتد من 60.3% إلى 73.1% ويتقاطع مع مجال GPT‑6.1 سول.
كل نموذج في ذلك الجدول هو من نماذج OpenAI. فالمعيار لـ OpenAI، والمهام طلبتها OpenAI، ولم يُشغّل عليه أي نظام منافس. والأرقام تصف حركة داخل تشكيلة مورّد واحد، لا ترتيبًا بين المختبرات.
أما عدّ الرموز فيسير في الاتجاه المعاكس للنتائج. فقد بلغ أسترا 66.7% بمتوسط 4,704 رمز مُخرَج لكل مهمة، في حين أنفق GPT‑5.2 27,620 رمزًا للوصول إلى 31.2%.
حيث لا يزال أفضل نموذج يفشل
نص OpenAI صريح بدرجة غير معتادة في وصف أخطاء أسترا. في مهمة تفاعل سلسلي للمستعمرات، جمّع النموذج الحزم تجميعًا صحيحًا لكنه أسند إلى كل مجموعة الهوية التجريبية الخطأ، إذ افترض أن الناتج الأكبر يدل على النسخة الناجحة: فاقترح المستعمرات 4 و6 و7 و8 حيث يختار المرجع 5 و9 و10 — خطأ كان سيدفع البلازميد الخطأ إلى مرحلة التنقية. وعندما طُلب منه عدّ المستعمرات على طبق، لم يفصل المتجاورة منها، وأغفل مستعمرات ظاهرة، ووضع علامات على آغار خال، وزاد العدّ بنحو 12%. وفي مهمة مجهرية لاحظ أن التضاد يتغير بعمق التركيز، ثم أسقط الملاحظة واستنتج أن الفجوات أغمق عمومًا من الخلية المحيطة بها، مع أن فجوات أفتح كانت في الحقل نفسه.
والنجاحات من جنس الأخطاء نفسه. فقد رفض أسترا طبق ضبط سالب بعد أن قرأ على حافته “LB Kan50” — كاناميسين، لا الأمبيسيلين الذي استُخدم في التجربة — وتعرّف على سلسلة من صور المجهر بأنها مسح في العمق، في حين كان GPT‑5.6 سول يبحث عن سبب حيوي لاختفاء الخلايا.
ما يجب مراقبته
تقول OpenAI إن المكاسب تشير إلى قدرة متعددة الوسائط أقوى ومدمجة في النموذج، لا إلى مزيد من الاستدلال. واختبار هذه القراءة هو ما إذا كان أحد من خارج OpenAI سيشغّل المعيار. وإلى أن يظهر نموذج منافس في الجدول، تبقى نسبة 66.7% رقمًا عن أسترا، لا عن حدود التقنية.