En test bygget af det rod, et laboratoriebord faktisk giver
OpenAI har offentliggjort BioBasicsBench, 100 opgaver, der beder AI-agenter om at tolke de rå beviser, en laboratorieforsker frembringer på en arbejdsdag — gelbilleder, agarskåle, mikroskopibilledstakke, instrumentskærme — og sige, hvad beviserne understøtter, også når de ikke understøtter noget. Ved det højeste ræsonneringsniveau, OpenAI oplyser for samtlige testede modeller, tog GPT‑6 Astra 66,7 procent af den tilgængelige point, mod 43,8 procent for GPT‑5.6 Sol.
Testen blev bygget med Ligo, et bioteknologiselskab, der arbejder med enzymdesign, og Ligos forskere skrev opgaverne ud fra deres egne eksperimenter. OpenAI hævder, at eksisterende tests samles af de diagrammer og billeder, der er udvalgt til offentliggørelse i artikler, hvilket udelader de mislykkede forsøg, de tvetydige billeder og de modstridende iagttagelser, som fylder et laboratorium i drift.
Hvad opgaverne indeholder
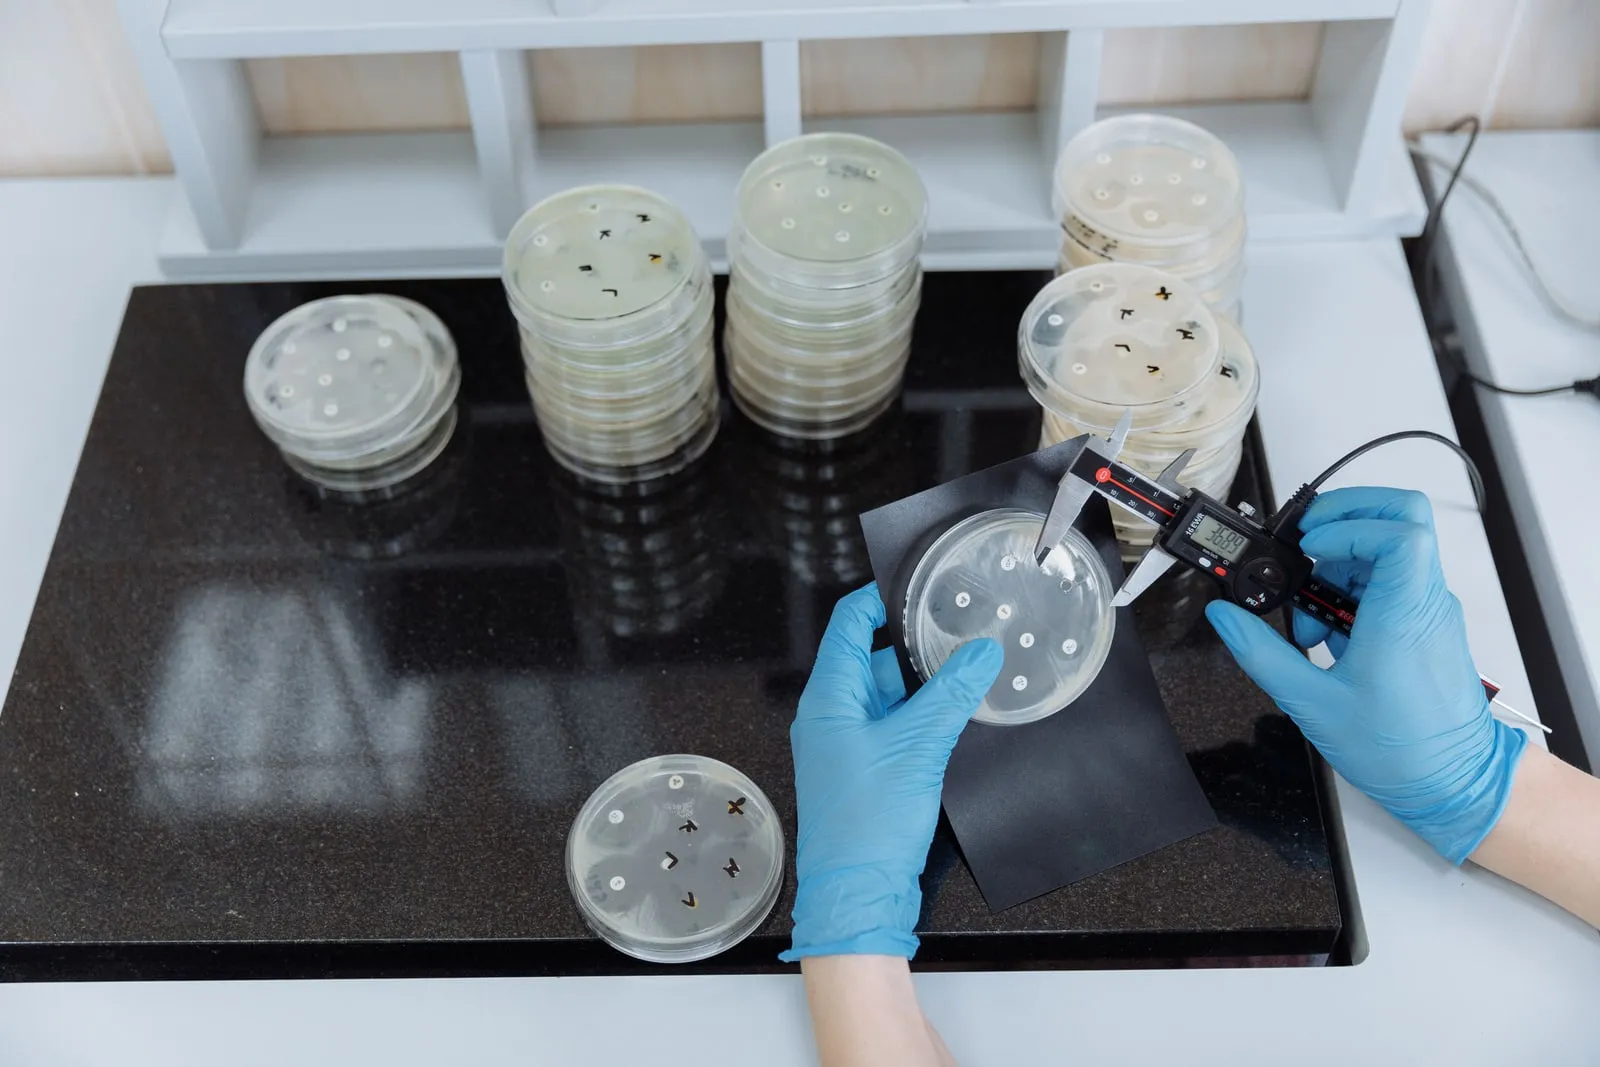
Opgaverne dækker fem områder: proteinmetoder, billede og cytometri, kvantificering og analyser, nukleinsyremetoder samt molekylær kloning. Geler og blots optræder i 31 af dem, protokoller og laboratorienoter i 27, instrumenteksporter og tabeller i 20 og fotografier af borde, stativer og reagenser i 18. Mikroskopi findes i 14, sekventeringsfiler i 12, og syv opgaver er videoer af bordarbejde: at udstryge en skål, rigge et elektroforesekar, veje på en vægt.
Hver opgave har en bedømmelsesskabelon skrevet af den forsker, der udformede den, så point gives kriterium for kriterium og ikke blot for slutsvaret. Det er det, der lader testen skelne en rigtig konklusion fra en delvis rigtig analyse. Hver opgave blev gennemgået internt af en Ligo-forsker, der ikke havde skrevet den, derefter eksternt af en forsker med ph.d.-grad, der arbejder i laboratorium, og derefter internt endnu en gang.
Pointene, og hvem der står i tabellen
OpenAI evaluerede syv modeller — GPT‑5.2, GPT‑5.4, GPT‑5.5, GPT‑5.6 Sol, GPT‑6.1 Sol, GPT‑6 Luna og GPT‑6 Astra — på 37 kombinationer af model og ræsonneringsindsats, med fem forsøg på hver af de 100 opgaver, altså 18.500 resultater. På niveauet xhigh er rækkefølgen Astra på 66,7 procent, GPT‑6.1 Sol på 62,0, GPT‑5.6 Sol på 43,8, GPT‑6 Luna på 38,3, GPT‑5.5 på 35,4, GPT‑5.4 på 33,2 og GPT‑5.2 på 31,2. Konfidensintervallerne er brede: Astras 95-procentinterval går fra 60,3 til 73,1 procent og overlapper GPT‑6.1 Sols.
Hver model i tabellen er OpenAIs egen. Testen er OpenAIs, opgaverne blev bestilt af OpenAI, og intet konkurrerende system er kørt på den. Tallene beskriver bevægelser inden for én leverandørs sortiment, ikke en rangordning mellem laboratorier.
Tokentallene går den modsatte vej af pointene. Astra nåede 66,7 procent på gennemsnitligt 4.704 outputtokens per opgave, mens GPT‑5.2 brugte 27.620 tokens for at nå 31,2 procent.
Hvor den bedste model stadig fejler
OpenAIs tekst er usædvanligt direkte om, hvad Astra gjorde forkert. I en opgave om koloni-PCR grupperede modellen båndene rigtigt, men gav hver gruppe den forkerte eksperimentelle identitet, fordi den antog, at det større produkt markerede den lykkede klon: den foreslog kolonierne 4, 6, 7 og 8, hvor referencen vælger 5, 9 og 10 — en fejl, der ville sende det forkerte plasmid videre til rensning. Bedt om at tælle kolonier på en skål kunne den ikke adskille tætte naboer, overså synlige kolonier, markerede tom agar og talte omkring 12 procent for højt. I en mikroskopiopgave bemærkede den, at kontrasten varierer med fokusdybden, og slap derefter iagttagelsen med konklusionen, at vakuoler generelt er mørkere end den omgivende celle, mens lysere lå i samme billedfelt.
Succeserne er af samme slags som fejlene. Astra forkastede en negativ kontrolskål efter at have læst “LB Kan50” på kanten — kanamycin, ikke det ampicillin, eksperimentet brugte — og genkendte en række mikroskopbilleder som en dybdescanning, hvor GPT‑5.6 Sol ledte efter en biologisk grund til, at cellerne var forsvundet.
Hvad man skal følge
OpenAI siger, at forbedringerne peger mod stærkere indbygget multimodal evne snarere end mod mere ræsonnering. Prøven på den læsning er, om nogen uden for OpenAI kører testen. Indtil en konkurrerende model står i tabellen, er 66,7 procent et tal om Astra, ikke om teknologiens front.