En test bygget av rotet en laboratoriebenk faktisk gir
OpenAI har publisert BioBasicsBench, 100 oppgaver som ber KI-agenter tolke de rå bevisene en laboratorieforsker lager i løpet av en arbeidsdag — gelbilder, agarskaler, mikroskopibildestabler, instrumentskjermer — og si hva bevisene støtter, også når de ikke støtter noe. På det høyeste resonneringsnivået OpenAI oppgir for alle modellene som ble testet, tok GPT‑6 Astra 66,7 prosent av tilgjengelig poengsum, mot 43,8 prosent for GPT‑5.6 Sol.
Testen ble bygget med Ligo, et bioteknologiselskap som arbeider med enzymdesign, og Ligos forskere skrev oppgavene ut fra sine egne eksperimenter. OpenAI hevder at eksisterende tester settes sammen av diagrammene og bildene som er valgt ut for publisering i artikler, noe som utelater de mislykkede forsøkene, de tvetydige bildene og de motstridende observasjonene som fyller et laboratorium i drift.
Hva oppgavene inneholder
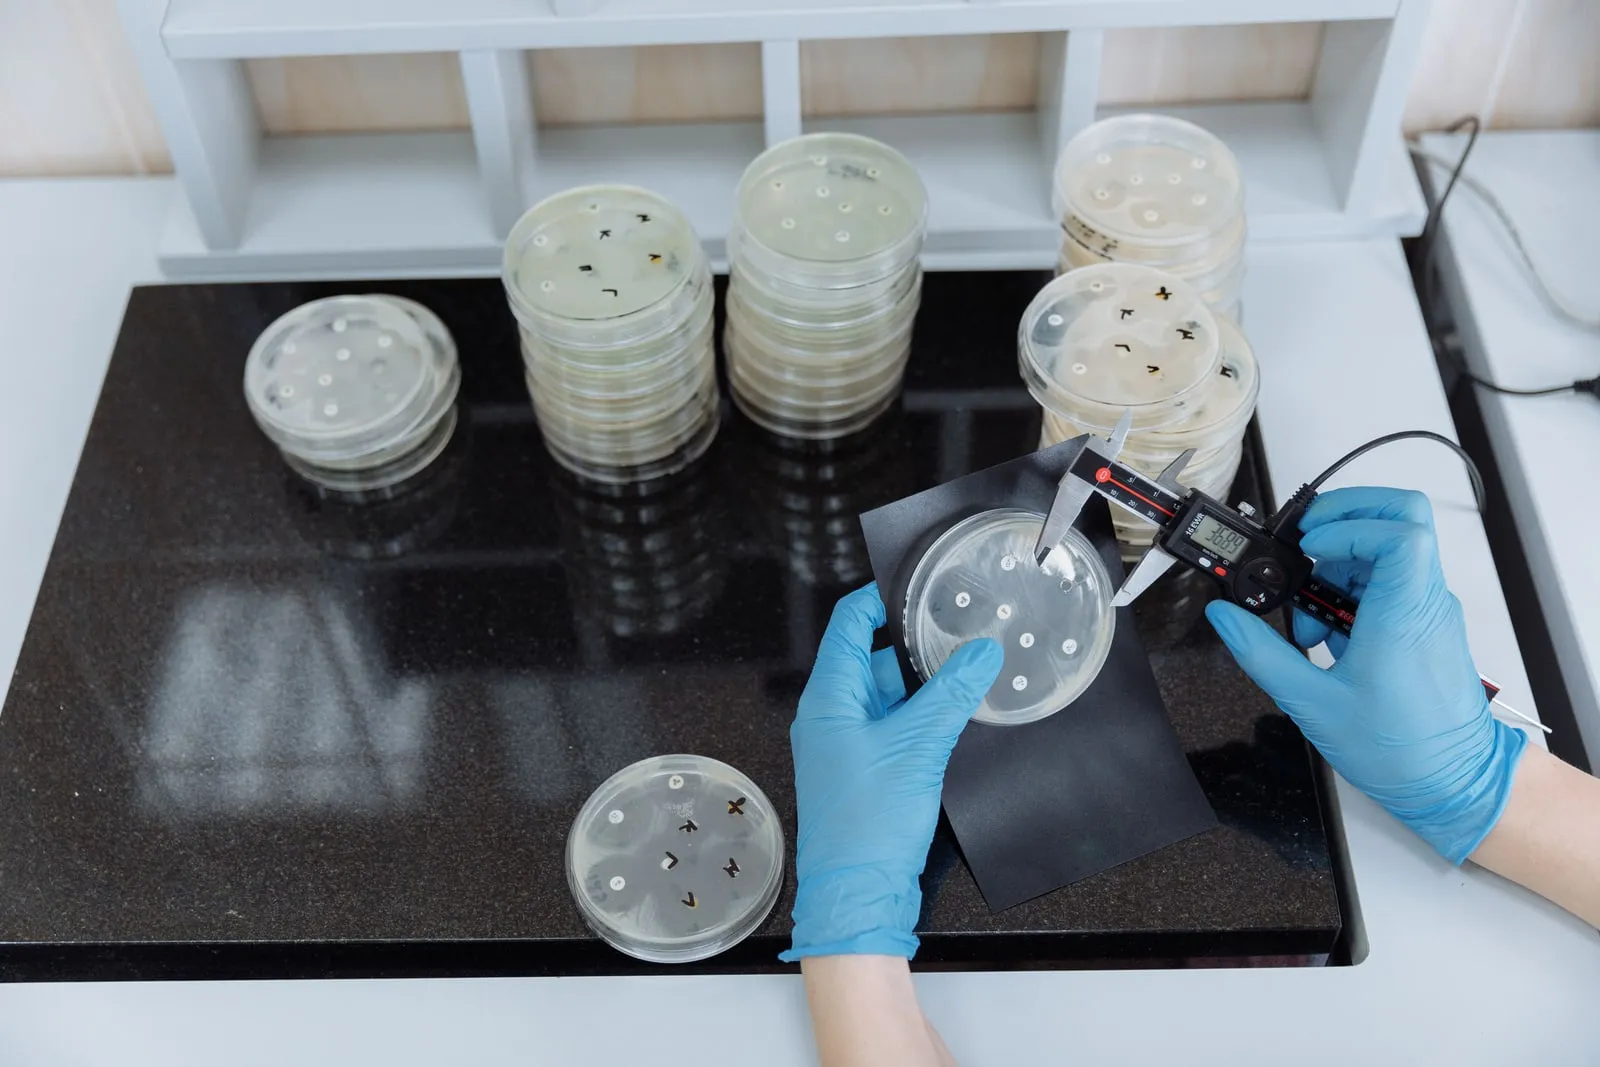
Oppgavene dekker fem områder: proteinmetoder, bilde og cytometri, kvantifisering og analyser, nukleinsyremetoder og molekylær kloning. Geler og blotter forekommer i 31 av dem, protokoller og laboratorienotater i 27, instrumenteksporter og tabeller i 20, og fotografier av benker, stativer og reagenser i 18. Mikroskopi finnes i 14, sekvenseringsfiler i 12, og sju oppgaver er videoer av benkarbeid: å stryke ut en skal, rigge et elektroforesekar, veie på en vekt.
Hver oppgave har en vurderingsmal skrevet av forskeren som utformet den, slik at poeng gis kriterium for kriterium og ikke bare for sluttsvaret. Det er det som lar testen skille en riktig konklusjon fra en delvis riktig analyse. Hver oppgave ble gjennomgått internt av en Ligo-forsker som ikke hadde skrevet den, deretter eksternt av en forsker med doktorgrad som arbeider i laboratorium, og så internt en gang til.
Poengene, og hvem som står i tabellen
OpenAI evaluerte sju modeller — GPT‑5.2, GPT‑5.4, GPT‑5.5, GPT‑5.6 Sol, GPT‑6.1 Sol, GPT‑6 Luna og GPT‑6 Astra — på 37 kombinasjoner av modell og resonneringsinnsats, med fem forsøk på hver av de 100 oppgavene, altså 18 500 resultater. På nivået xhigh er rekkefølgen Astra på 66,7 prosent, GPT‑6.1 Sol på 62,0, GPT‑5.6 Sol på 43,8, GPT‑6 Luna på 38,3, GPT‑5.5 på 35,4, GPT‑5.4 på 33,2 og GPT‑5.2 på 31,2. Konfidensintervallene er vide: Astras 95-prosentintervall går fra 60,3 til 73,1 prosent og overlapper GPT‑6.1 Sols.
Hver modell i tabellen er OpenAIs egen. Testen er OpenAIs, oppgavene ble bestilt av OpenAI, og ingen konkurrerende system er kjørt på den. Tallene beskriver bevegelser innenfor én leverandørs utvalg, ikke en rangering mellom laboratorier.
Tokentallene går motsatt vei av poengene. Astra nådde 66,7 prosent på gjennomsnittlig 4 704 utdatatokener per oppgave, mens GPT‑5.2 brukte 27 620 tokener for å nå 31,2 prosent.
Der den beste modellen fortsatt svikter
OpenAIs tekst er uvanlig direkte om hva Astra gjorde feil. I en oppgave om koloni-PCR grupperte modellen båndene riktig, men ga hver gruppe feil eksperimentell identitet fordi den antok at det større produktet markerte den lykkede klonen: den foreslo koloniene 4, 6, 7 og 8 der referansen velger 5, 9 og 10 — en feil som ville sende feil plasmid videre til rensing. Bedt om å telle kolonier på en skal klarte den ikke å skille nærliggende kolonier, overså synlige kolonier, markerte tom agar og telte omtrent 12 prosent for høyt. I en mikroskopioppgave bemerket den at kontrasten varierer med fokusdybden, og forlot deretter observasjonen med konklusjonen at vakuoler jevnt over er mørkere enn cellen rundt, mens lysere lå i samme bildefelt.
Treffene er av samme slag som bommene. Astra forkastet en negativ kontrollskal etter å ha lest “LB Kan50” på kanten — kanamycin, ikke ampicillinet eksperimentet brukte — og gjenkjente en serie mikroskopbilder som en dybdeskanning der GPT‑5.6 Sol lette etter en biologisk grunn til at cellene var forsvunnet.
Hva man bør følge
OpenAI sier at forbedringene peker mot sterkere innebygd multimodal evne snarere enn mot mer resonnering. Prøven på den lesningen er om noen utenfor OpenAI kjører testen. Inntil en konkurrerende modell står i tabellen, er 66,7 prosent et tall om Astra, ikke om teknologiens front.