Vad som släpptes
Allen Institute for AI publicerade på torsdagen Olmo-core 3, ett öppet träningsramverk för stora språkmodeller av typen mixture-of-experts, tillsammans med en teknisk rapport och en interaktiv demo.
En mixture-of-experts-modell dirigerar varje token till en liten delmängd av sina parametrar, så att den totala kapaciteten kan växa utan att kostnaden för varje framåtpassning växer med den. Det är därför nästan varje frontmodell i dag är gles. Det är också därför det är svårare att träna en sådan än en tät modell: dirigeringen måste lastbalanseras över enheter, och det kommunikationsmönster den skapar är det som avgör om hårdvaran arbetar eller står still.
Siffrorna
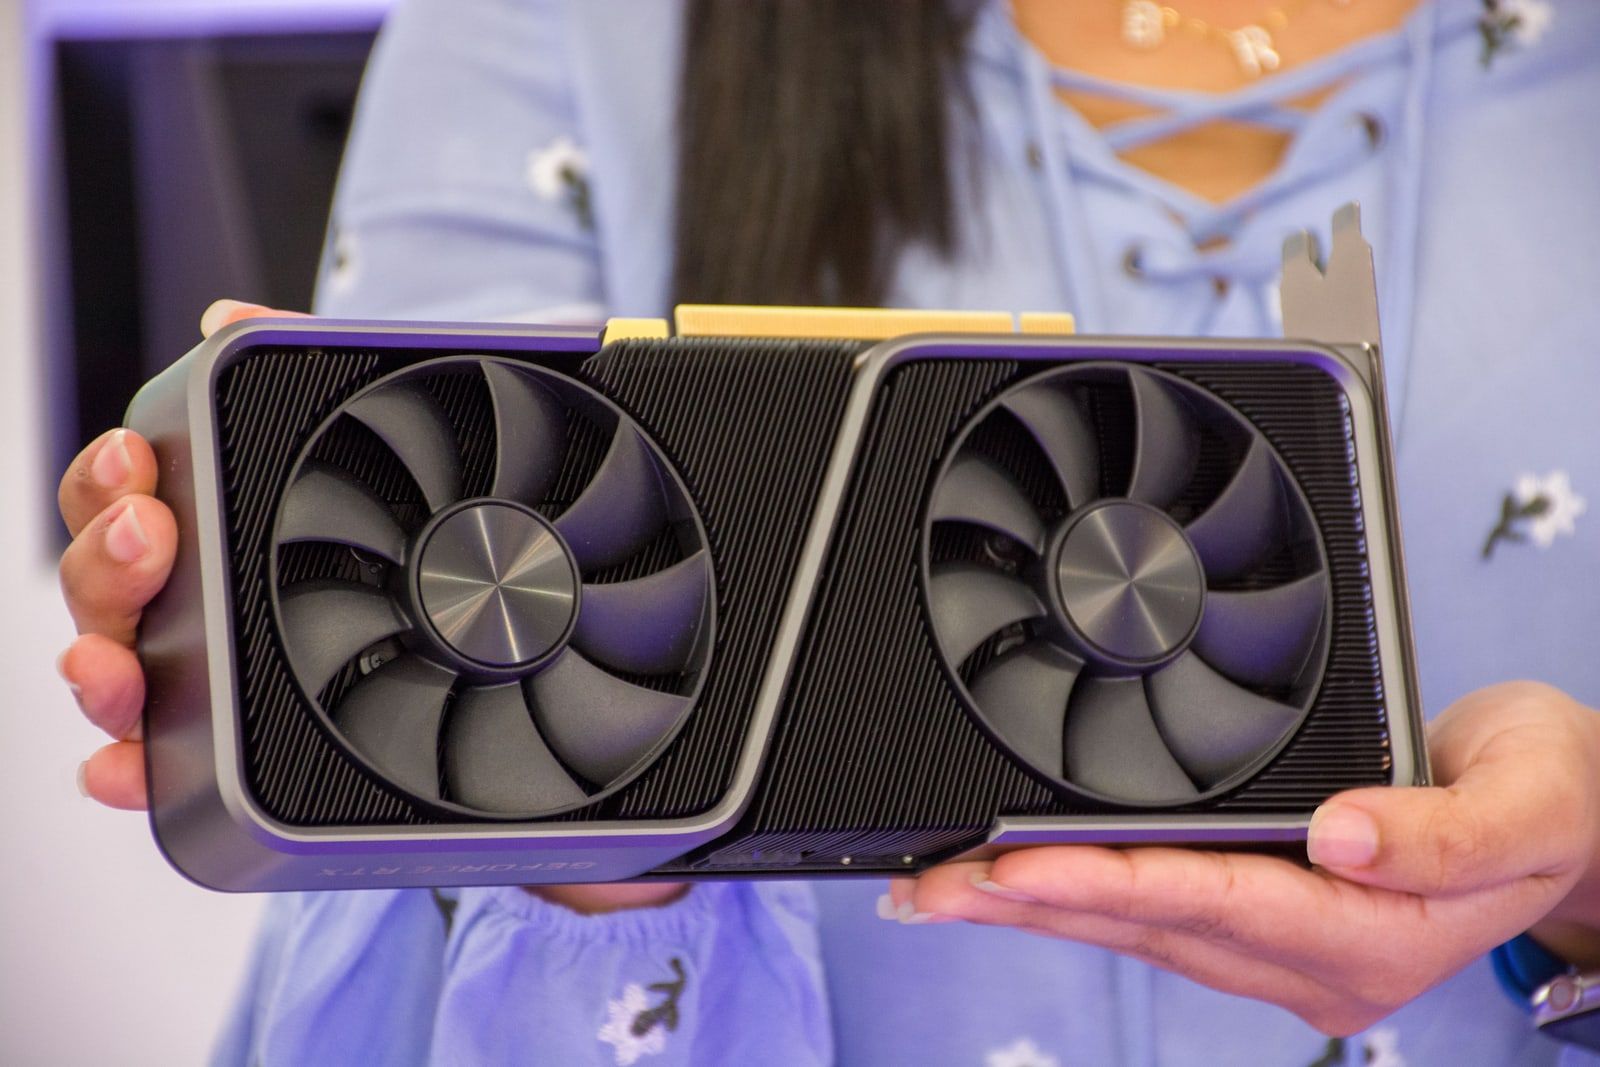
I ett preliminärt test på åtta Nvidia B300-grafikkort säger Ai2 att en mixture-of-experts med 47 miljarder parametrar behandlade 52 000 token per sekund och grafikkort med den nya stacken, mot 19 400 med den tidigare lösningen byggd på PyTorchs FSDP — ungefär 2,7 gånger genomströmningen.
Kapacitetssiffrorna är den andra halvan. Ai2 utökade expertpoolen från 8 till 128 med fortsatt fyra aktiva experter per token, vilket tog de totala parametrarna från 4,6 miljarder till 47 miljarder med runt 3,2 miljarder aktiva per token, och kostade mindre än 5 procent av träningsgenomströmningen.
I stor skala rapporterar institutet att det mätt en konfiguration med 1,2 biljoner parametrar och 58,36 miljarder aktiva per token fördelade över 512 B300-kort, med en högsta observerad genomströmning på 858 TFLOP/s per kort, och ett ytterligare test på 2,38 biljoner parametrar med DeepEP v2. Att slå på talformatet MXFP8 där det hjälpte mest gav omkring 21 procent högre genomströmning än BF16-referensen, och sänkte det högsta aktiva minnet från 103 GiB till 95 GiB.
Detta är institutets egna mätningar av sitt eget ramverk, publicerade tillsammans med släppet.
Varför infrastrukturen betyder mer än vikterna
Modeller med öppna vikter är numera vanliga. Öppen träningsinfrastruktur som klarar en gles körning med en biljon parametrar är det inte, och det är den del som avgör om en universitetsgrupp eller ett litet labb kan göra något annat än att finjustera någon annans kontrollpunkt.
Ai2 har varit konsekvent i detta: Olmo-linjen har släppt data, kod och mellanliggande kontrollpunkter, inte bara vikter. Olmo-core 3 utvidgar det till det lager som vanligen vaktas hårdast, eftersom prestandan i distribuerad träning är där en stor del av ett frontlabbs praktiska försprång faktiskt ligger.
Reservationen är hårdvaran. Siffrorna kommer från B300-kort, och en stack avstämd för Nvidias nyaste delar är mindre användbar för en grupp som kör äldre acceleratorer, vilket är de flesta grupper utanför de välfinansierade.
Vad man ska följa är om någon utanför Ai2 återskapar genomströmningssiffrorna på sitt eget kluster. Ett öppet ramverk är bara så bra som sin andra användare.